源排序
列表顺序就是检索顺序,排在前面的先返回,常用的放上面。
它更像一张订阅列表:你订什么,就有什么。
venera 本体不收录任何作品。接进来的每一个源,其实是一段负责「翻译」的脚本:把某个漫画站的搜索、详情、章节与图片地址,翻译成客户端能读的格式。源里有什么,客户端就能搜到什么;源里没有的,客户端也变不出来。
所以「为什么搜不到这本书」这个问题,答案往往不在客户端里,而在源里。换一个收录更广的源,同一本书立刻就出来了 —— 这也是为什么要留几个不同来源的源备用。
源还会失效。对方站点改版、换域名、加验证,脚本就可能读不到数据。这不是客户端的问题,等源作者更新即可,已缓存的内容与书架记录都不受影响。
围绕「源」这件事,客户端提供了几个必要的手动开关。
列表顺序就是检索顺序,排在前面的先返回,常用的放上面。
不常用的源停用而不删除,检索时不会被它拖慢。
某个源报错时只更新它,不必整批重新导入。
同一作品在多个源出现时按标题归并,点进详情再比章节数。
某些源自带分类与排行,可以只在它内部翻。
源连不上时结果页会标出来,不会静默少几条。
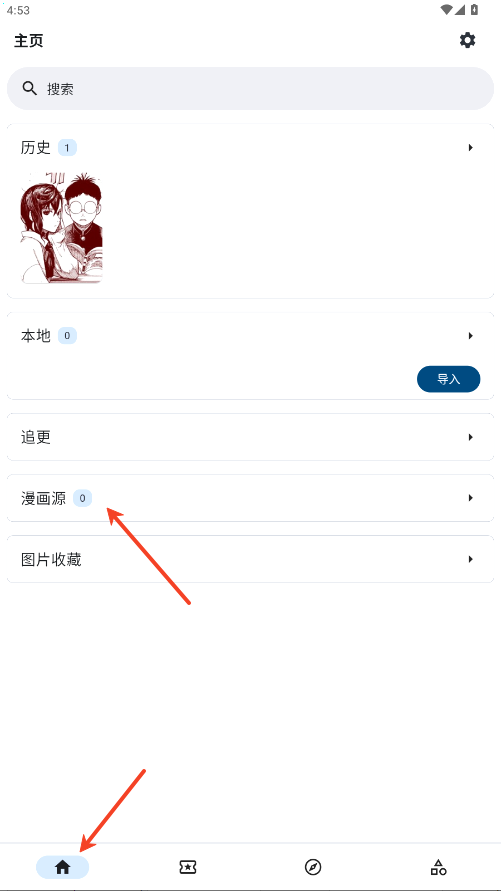
从阅读器到详情、登录与我的,源接通之后的四屏。
不是客户端在偷懒,而是在等最慢的那一个。
按影响程度从大到小排列。
| 因素 | 表现 | 处置 |
|---|---|---|
| 启用的源太多 | 结果出得慢,进度条一直在转 | 停用不常用的,只留三到五个 |
| 某个源连不上 | 其余源都出结果了,整体仍在等 | 把报错的源停用 |
| 源站本身慢 | 单独搜这个源也慢 | 换同类源,或只在需要时启用 |
| 关键词太宽 | 结果条数巨大,渲染也慢 | 加作者名或题材词收窄 |
停用一个源不会影响它已经缓存到本地的章节。
顺序不是装饰,它决定了你第一眼看到什么。
检索是并发发出的,但结果按源的顺序拼接。排在前面的源先出,你第一眼看到的就是它的结果;排在后面的要等前面的渲染完才轮到。想少翻几屏,就把握手最快的源放最上面。
判断哪个源快,有个笨办法:只启用一个源,搜同一个词,记下出结果的时间;换下一个再试。三次之后顺序自然就出来了,比凭印象排靠谱。
顺序调整后不需要重新导入源,保存即生效,下一次检索按新顺序走。
一篇讲源怎么维护,一篇讲结果怎么挑。
用得久的人,最后都简化成了三四个源。
一开始接了二十个源,搜一次要等好久。后来只留四个,快了一倍不止。南山 · 追更党
源报错的时候结果页会标出来,这点比默默少几条强太多,至少知道该换哪个。Rui · 折腾派
把最常用的那个源排到第一位,第一屏基本就够选了。小柯 · 只用三个源
接源与检索最常被问到的六条。
接上、搜一次、再加第二个,顺序比数量重要。